Böyük dil modeli və ya LLM (Large Language Model) insan dilindəki nümunələri öyrənərək mətnlə işləyən süni intellekt sistemidir. O, sualı oxuyur, konteksti hesaba qatır və ehtimala əsasən ən uyğun davamı yaradır. Bu izah LLM-i sehrli cavab maşını kimi deyil, imkanları və məhdudiyyətləri olan texnologiya kimi anlamağa kömək edir.
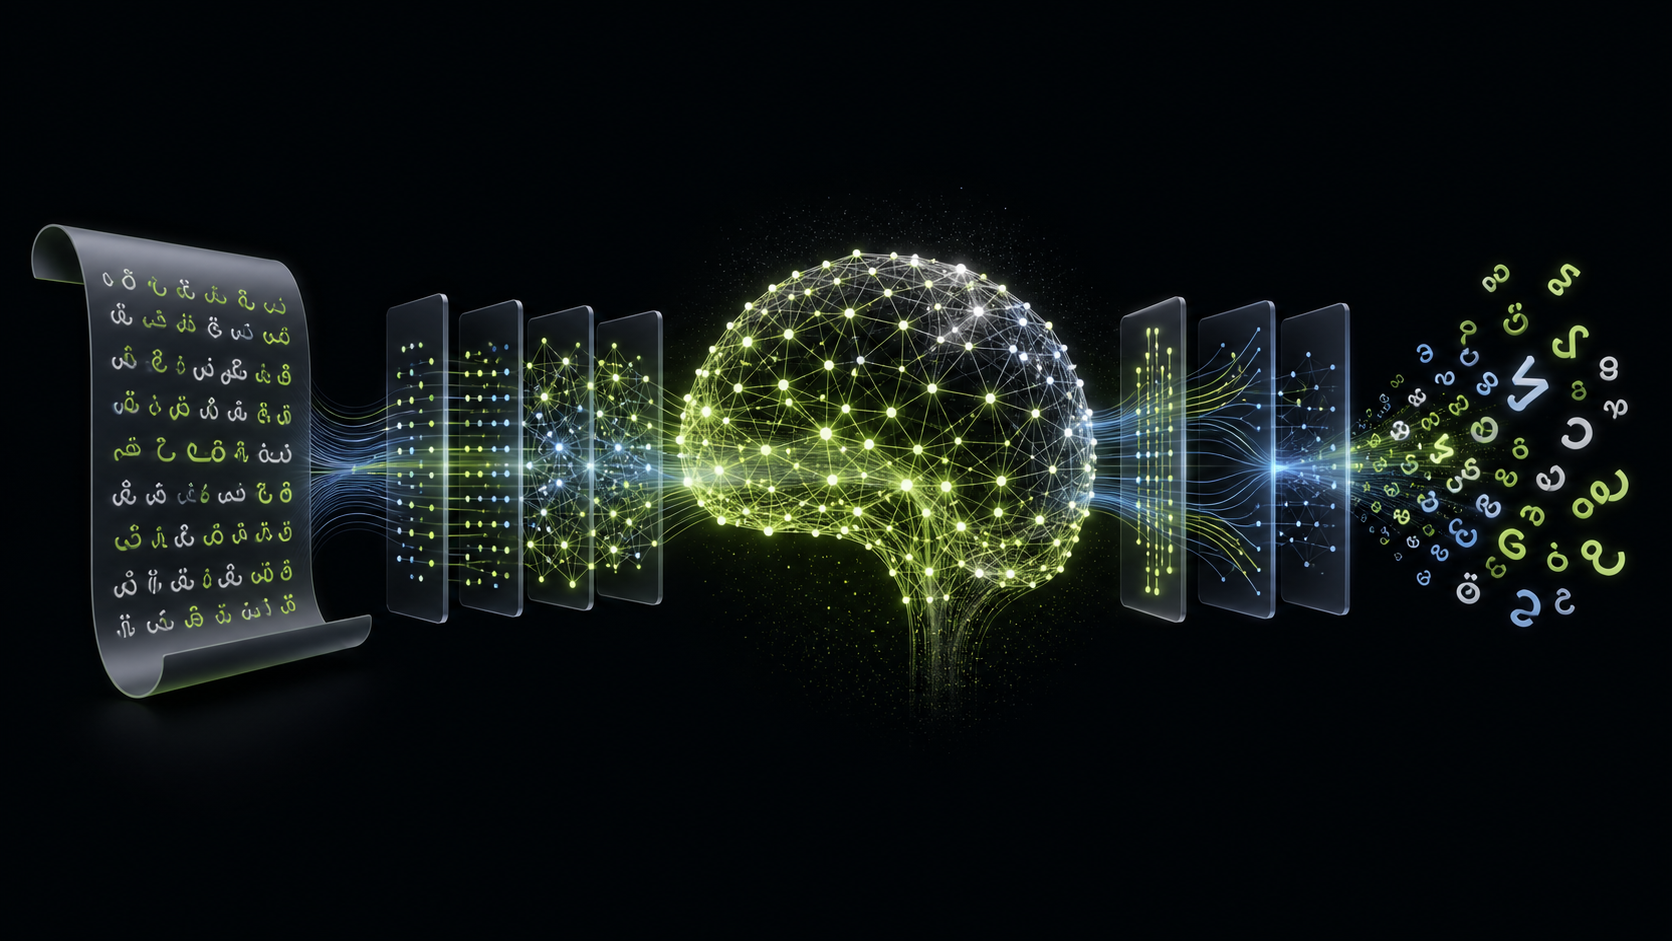
SADƏ DİAQRAM
LLM cavabının yaranma axını
- 01Sorğuİstifadəçi sualı və ya təlimatı yazır.
- 02TokenlərMətn modelin işlədiyi kiçik vahidlərə ayrılır.
- 03KontekstModel sözlər arasındakı əlaqələri hesablayır.
- 04NəticəƏn münasib növbəti tokenlər ardıcıl seçilir.
Hər mərhələ ehtimala əsaslanır; faktların ayrıca mənbə ilə yoxlanması məhsulun məsuliyyətidir.
LLM nədir: qaydaları əzbərləyən proqram deyil
Ənənəvi proqramda tərtibatçı əvvəlcədən qayda yazır: əgər istifadəçi bu düyməni basırsa, sistem həmin əməliyyatı etsin. Böyük dil modelində isə əsas mexanizm fərqlidir. Model çoxlu mətn nümunəsində sözlərin, cümlələrin və fikirlərin hansı ardıcıllıqla gəldiyini öyrənir. Buna görə o, eyni mövzuda müxtəlif formada verilmiş suallara cavab qura, mətni qısalda, başlıq təklif edə və ya mürəkkəb ifadəni sadələşdirə bilir. LLM insan kimi “bilmək” və ya “düşünmək” iddiası daşımır; hesablamalı təmsillər əsasında dil nümunələrini davam etdirir. Bu fərqi qəbul etmək düzgün gözlənti qurmaq üçün vacibdir.
“Böyük” sözü yalnız parametr sayını bildirmir, həm də modelin çox müxtəlif dil əlaqələrini öyrənə bilməsini ifadə edir. Parametrlər təlim zamanı tənzimlənən ədədi əlaqələrdir. Onlar modelin mətn daxilində hansı sözün, terminoloji quruluşun və ya üslubun daha uyğun görünə biləcəyini hesablamağa imkan verir. Ancaq parametr çoxluğu avtomatik etibarlılıq demək deyil. Modelin nəticəsi məlumatın keyfiyyətindən, tapşırığın dəqiqliyindən, verilən kontekstdən və məhsulun üzərinə qoyulan nəzarət mexanizmlərindən birlikdə asılıdır. Ona görə LLM seçərkən təkcə ölçünü deyil, dil uyğunluğunu, gecikməni, təhlükəsizliyi və ölçülə bilən keyfiyyət meyarlarını da qiymətləndirmək lazımdır.
Mətn niyə tokenlərə bölünür?
Kompüter mətnə insan gözü ilə baxmır. LLM əvvəlcə daxil olan cümləni token adlanan hissələrə ayırır. Token tam söz, sözün bir parçası, durğu işarəsi və ya tez-tez təkrarlanan ifadə ola bilər. “Azərbaycan dilində süni intellekt” yazısı bir neçə tokenə bölünə bilər və model həmin tokenlərin bir-birinə münasibətini hesablayır. Bu mərhələ sadə görünsə də, Azərbaycan dili üçün xüsusilə önəmlidir: şəkilçilər, apostroflar, xüsusi hərflər, birləşik sözlər və terminlər tokenləşdirmənin səmərəliliyinə təsir edir. Səmərəsiz bölünmə eyni fikri ifadə etmək üçün daha çox token, daha yüksək xərc və bəzən zəif dil axıcılığı yarada bilər.
Tokenlər ardıcıllığa çevrildikdən sonra model onların mövqeyini və qarşılıqlı əlaqəsini emal edir. Məsələn, “bu müqaviləni qısalt” cümləsində “bu” sözünün hansı sənədə aid olduğunu anlamaq üçün model əvvəlki kontekstdəki məlumatı nəzərə almalıdır. Müasir diqqət, yəni attention mexanizmləri məhz bu əlaqələri hesablamağa kömək edir. Model hər sözə eyni dərəcədə baxmır; cavab üçün daha vacib hissələrə daha çox çəki verir. Bu, uzun sənəddə mövzunu tapmağı, sual-cavabda konteksti qorumağı və çoxmərhələli təlimatı izləməyi mümkün edir. Yenə də mexanizm mənanı insan kimi dərk etmir, statistik uyğunluğu hesablayır.
Cavab necə yaranır: növbəti token ehtimalı
LLM-in əsas işi növbəti tokenin ehtimalını hesablamaqdır. İstifadəçi “Müştəriyə nəzakətli cavab yaz” dedikdə model əvvəlki bütün tokenlərə baxır və mümkün davamların ehtimallarını yaradır. Sonra seçmə strategiyasına uyğun olaraq növbəti tokeni müəyyənləşdirir, bu tokeni kontekstə əlavə edir və proses təkrar olunur. Minlərlə belə kiçik seçim birləşərək cümləyə, sonra paraqrafa çevrilir. Bu səbəbdən modelin “yaradıcılığı” əslində ehtimal paylanmasından seçim etməsidir. Temperatur kimi parametrlər seçimdə nə qədər müxtəlifliyə icazə verildiyini dəyişə bilər: aşağı parametr daha sabit, yüksək parametr isə daha rəngarəng, amma potensial olaraq daha riskli nəticə verir.
Bu prosesin praktik nəticəsi odur ki, eyni sorğu bəzən fərqli cavablar verə bilər. Məhsul komandası üçün bu həm imkan, həm də məsuliyyətdir. Yaradıcılıq tələb edən məzmun, ideya siyahısı və ilkin qaralama üçün müxtəliflik faydalıdır. Hüquqi qayda, maliyyə hesablaması, tibbi məlumat və ya rəsmi vətəndaş xidməti üçün isə cavabın yoxlanması, mənbəyə bağlanması və sərt formatlanması daha vacibdir. Etibarlı sistem modeli tək buraxmır: axtarış, qayda mühərriki, kalkulyator, insan təsdiqi və loqlaşdırma ilə birləşdirir. Beləliklə, LLM dil interfeysi rolunu oynayır, qərarın yeganə mənbəyi olmur.
Təlim, fine-tuning və istifadə vaxtı arasındakı fərq
Əsas təlim mərhələsində model böyük həcmdə mətn üzərində dil nümunələrini öyrənir. Bu, enerji və hesablama baxımından bahalı prosesdir, lakin modelin ümumi dil qabiliyyətinin təməlini yaradır. Sonrakı mərhələdə təlimatlar, dialoqlar və seçilmiş nümunələr vasitəsilə modelin davranışı daha faydalı formaya yönləndirilə bilər. Buna bəzən instruction tuning və ya fine-tuning deyilir. Məsələn, Azərbaycan dilində müştəri dəstəyi üçün modelə nəzakətli ton, qısa cavab və rəsmi terminologiya nümunələri göstərilə bilər. Hər dəyişiklik qiymətləndirmə ilə müşayiət olunmalıdır; çünki dar tapşırıqda irəliləyiş başqa tapşırıqda geriləmə yarada bilər.
İstifadə vaxtı, yəni inference mərhələsində isə model artıq öyrəndiyi parametrlərdən istifadə edərək real sorğuya cavab verir. Şirkətin daxili məlumatı tez-tez dəyişirsə, onu yenidən əsas təlimə qatmaq düzgün yol olmaya bilər. Bu halda RAG yanaşması ilə sorğuya uyğun sənədlər tapılır və modelə kontekst kimi verilir. Məsələn, qiymət cədvəli, məhsul təlimatı və ya daxili prosedur yeniləndikdə yalnız sənəd bazası yenilənir. Bu ayrım həm əməliyyat xərclərini azaltmağa, həm də cavabın hansı mənbəyə söykəndiyini göstərməyə kömək edir. Hər üç mərhələ müxtəlif məqsəd və risk daşıyır.
LLM-dən düzgün istifadə üçün beş prinsip
Birinci prinsip tapşırığı konkret yazmaqdır. “Mənə kömək et” əvəzinə auditoriyanı, məqsədi, dili, tonu, çıxış formatını və məhdudiyyətləri qeyd edin. İkinci prinsip faktla fikir ayrımını qorumaqdır: modelin yazdığı rəqəmləri, tarixləri və hüquqi iddiaları etibarlı mənbədən yoxlayın. Üçüncü prinsip real istifadə ssenarisi ilə test etməkdir. Laboratoriya nümunəsi deyil, şirkətinizdə rast gəlinən sorğular, səhv yazılışlar, qısa cümlələr və çətin dialoqlar qiymətləndirməyə daxil edilməlidir. Dördüncü prinsip şəxsi və məxfi məlumatın necə emal edildiyini aydınlaşdırmaqdır.
Beşinci prinsip insan nəzarətini risk səviyyəsinə uyğun qurmaqdır. Marketinq mətninin ilk qaralaması ilə kredit qərarı eyni avtomatlaşdırma dərəcəsinə malik olmamalıdır. Aşağı riskli işlərdə modelin nəticəsi redaktora sürət qazandıra bilər; yüksək riskli işlərdə isə cavab yalnız məsləhət xarakteri daşımalı, təsdiqlənməli və izah edilə bilməlidir. Azərbaycan dilində LLM layihəsi üçün ayrıca dil keyfiyyəti, termin uyğunluğu və yerli kontekst testləri də vacibdir. Doğru arxitektura ilə LLM sadəcə maraqlı texnologiya deyil, komandanın işini ölçülə bilən şəkildə yaxşılaşdıran etibarlı məhsul komponentinə çevrilir.
Praktik tətbiq üçün yekun yoxlama
“Böyük dil modeli — LLM nədir və necə işləyir?” mövzusunda növbəti addımı texnologiyadan deyil, konkret istifadəçi problemindən başlayaraq seçin. Hədəf auditoriyanı, cavabın təsir etdiyi qərarı, istifadə olunacaq məlumatı və qəbul edilən risk səviyyəsini bir səhifəlik sənəddə aydınlaşdırın. Sonra həmin ssenaridə bu gün nə qədər vaxt sərf olunduğunu, hansı səhvlərin baş verdiyini və istifadəçinin hansı çətinliklə üzləşdiyini ölçün. Bu ilkin göstərici olmadan AI həllinin həqiqi faydasını və ya yan təsirini qiymətləndirmək mümkün deyil.
Kiçik pilotda nəticəni Azərbaycan dili, fakt və ya mənbə dəqiqliyi, istifadəçi təcrübəsi, gecikmə və təhlükəsizlik baxımından birgə yoxlayın. Yalnız ideal sorğunu deyil, qısa, səhv yazılmış, qeyri-müəyyən və riskli müraciətləri də sınayın. Cavabın modeldən, məlumatdan, axtarışdan və ya proses qaydasından hansı səbəblə yarandığını izləmək üçün versiyaları qeyd edin. Bu yanaşma problemi tez tapmağa, məhsulu təhlükəsiz təkmilləşdirməyə və komandanın qərarını fikrə yox, dəlilə əsaslandırmağa kömək edir.
Ən sonda insanın rolunu açıq saxlayın. Aşağı riskli işdə AI qaralama və axtarış köməkçisi ola bilər, yüksək təsirli qərarda isə səlahiyyətli ekspertin yoxlaması, rəsmi mənbə və eskalasiya yolu qorunmalıdır. Modelin və ya məlumat bazasının imkanları dəyişdikcə eyni qiymətləndirmə dövrünü yenidən işə salın. Qərar jurnalında istifadə olunan məlumat versiyasını, model konfiqurasiyasını, cavabın harada istifadə edildiyini və kimin təsdiqlədiyini qeyd edin. Bu məlumat sonradan keyfiyyət araşdırması, audit və komanda təlimi üçün praktik sübuta çevrilir. Beləliklə, bu mövzudakı AI təşəbbüsü bir dəfəlik demo deyil, istifadəçiyə real fayda verən və məsuliyyətlə idarə olunan məhsul imkanına çevrilir.
FAQ
Tez verilən suallar
LLM axtarış sistemi ilə eynidirmi?
Xeyr. LLM mətn yaradır; axtarış sistemi isə mənbə tapır. Etibarlı məhsulda bu iki komponent birlikdə işləyə bilər.
LLM hər sualın düzgün cavabını verirmi?
Xeyr. O, inandırıcı görünən, lakin yanlış və ya köhnəlmiş məlumat yarada bilər. Vacib faktlar ayrıca yoxlanmalıdır.
Azərbaycan dilli LLM seçərkən nəyə baxmalıyam?
Dil keyfiyyəti, terminologiya, gecikmə, təhlükəsizlik, inteqrasiya tələbi və real ssenaridə ölçülmüş nəticələr əsas meyarlardır.